

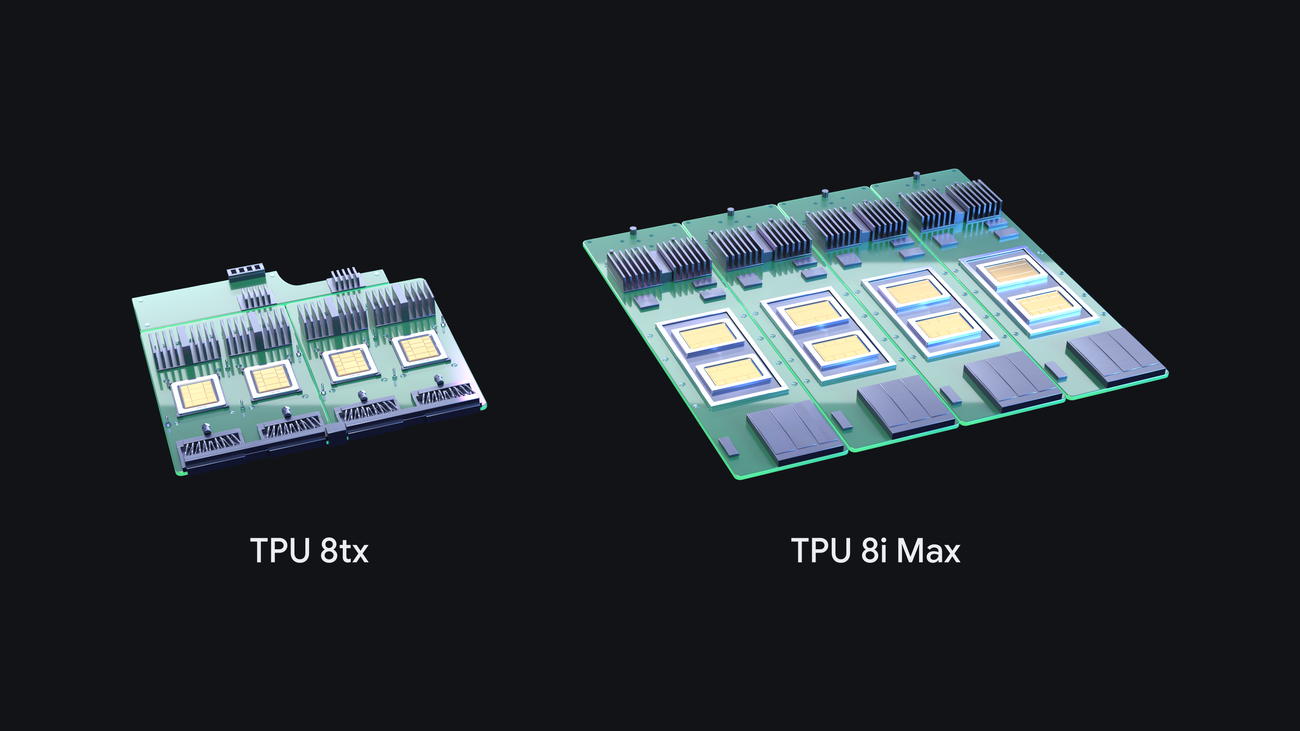
Google amplia il portafoglio di acceleratori TPU di ottava generazione con due nuovi sistemi: TPU 8tx, pensato per l’inferenza in ambienti riservati, e TPU 8i Max, orientato a finestre di contesto molto ampie e alla densità di calcolo per rack. Con queste uscite la famiglia comprende quattro configurazioni nello stesso anno, dopo TPU 8t e TPU 8i presentate a Google Cloud Next ad aprile.
Quattro sistemi per il ciclo di vita dell’AI agentica
Secondo Google, le TPU servono oggi su più fronti: addestramento e servizio dei modelli Gemini, carichi di lavoro agentici, clienti di Google Cloud e, più di recente, installazioni nei data center dei clienti. L’azienda parla di un’attività in rapida crescita, con quasi cento clienti tra laboratori di ricerca, società di trading, retailer e università.
Le basi della generazione restano quelle annunciate in primavera. TPU 8t punta sull’addestramento su larga scala, con prestazioni di training fino a 2,7 volte superiori rispetto alla generazione precedente. TPU 8i è dedicata al ragionamento in tempo reale e, sempre secondo Google, migliora dell’80% il rapporto prezzo-prestazioni sull’inferenza. I due nuovi sistemi riprendono quei chip e li riconfigurano per due esigenze che emergono con gli agenti autonomi in produzione: sicurezza dei dati a livello hardware e contesto da milioni di token.
TPU 8tx: confidential compute a livello hardware
TPU 8tx è orientata a imprese regolamentate e a enti pubblici che gestiscono modelli proprietari e dati sensibili. Usa lo stesso silicio di TPU 8t, affiancato a CPU host AMD EPYC di quinta generazione, e costruisce la sicurezza direttamente nell’hardware: i dati e i pesi del modello restano protetti e isolati anche durante l’elaborazione. Google lo presenta come un sistema di confidential compute per fine-tuning privato ed esecuzione sicura di agenti.
Con la rete a bassa latenza Boardfly, pensata per il ragionamento in tempo reale, TPU 8tx promette una latenza fino a due volte inferiore rispetto a TPU 8t, con un impatto sulle prestazioni quasi nullo. Sulla stessa macchina i team possono personalizzare i modelli sui propri dati, distillare modelli grandi in versioni più piccole e addestrare agenti con apprendimento per rinforzo, senza spostare informazioni riservate tra cluster diversi.
TPU 8i Max: due chip 8i nello stesso package
TPU 8i Max affronta il cosiddetto “memory wall”. Quando tanti agenti lavorano insieme su una codebase intera o su ore di video, la larghezza di banda della memoria diventa il collo di bottiglia. Google ha messo due chip TPU 8i a bassa latenza in un unico package: rispetto a TPU 8i raddoppiano potenza di calcolo, capacità SRAM e banda HBM. Nella stessa superficie di rack entra il doppio del silicio, quindi più densità di calcolo per unità di spazio e per watt.
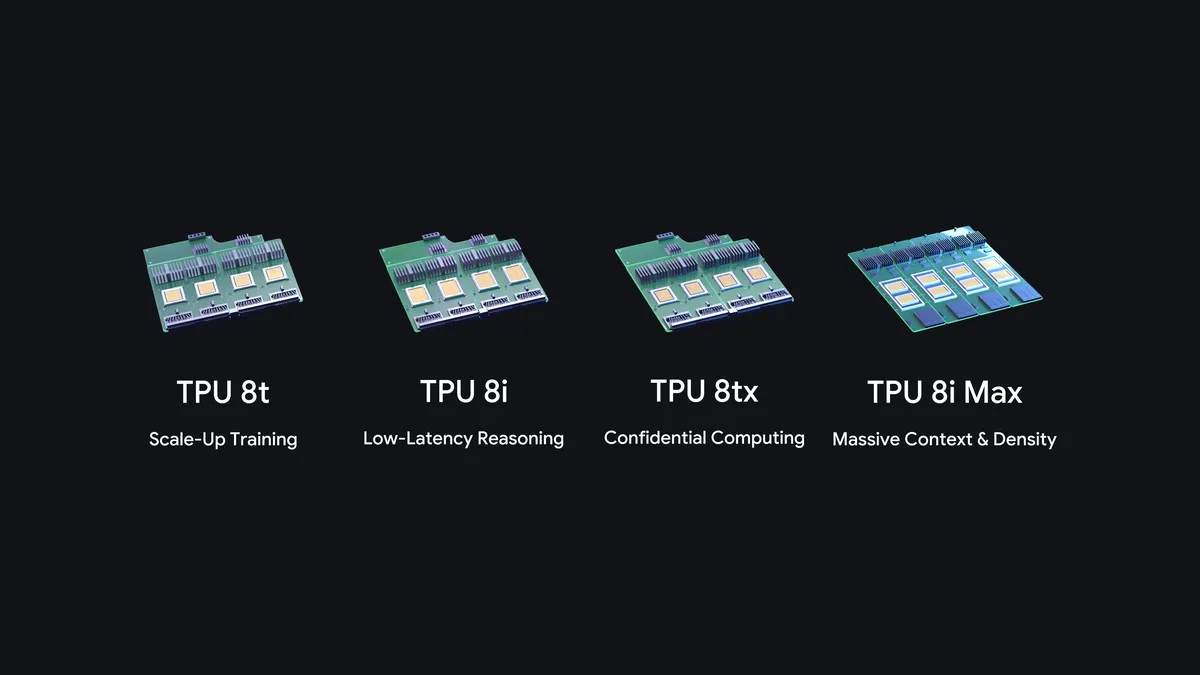
Nel complesso la famiglia punta a fasi diverse del ciclo agentico: 8t per l’addestramento su scala, 8i per il ragionamento a bassa latenza, 8tx per il confidential computing e 8i Max per contesti molto ampi e densità massima per rack. Il lavoro sui chip resta condiviso con Google DeepMind, come nelle generazioni precedenti. Le TPU Google compaiono anche fuori dai data center terrestri: di recente, nel Project Suncatcher, un prototipo in orbita ha generato la prima risposta di un modello eseguito su TPU nello spazio.
Software aperto: TorchTPU, Sync e agenti per sviluppatori
Sul fronte software Google ha reso open source TorchTPU, così codice PyTorch e modelli Hugging Face girano in modo nativo sulle TPU, con backend anche per motori di inferenza come vLLM e SGLang. In anteprima arriva una suite open source di agenti per TPU che si collega a strumenti di sviluppo come Claude Code, Cursor e Google Antigravity, per automatizzare l’adozione dell’hardware e il tuning dei kernel in linguaggio naturale.
Google rende open source anche TPU Sync, il livello di gestione dello stato dei modelli nei cluster TPU. Unifica HBM del chip, DRAM dell’host, storage condiviso e rete in un’unica gerarchia di memoria: secondo l’azienda riduce di oltre il 90% la latenza nel trasferimento della cache KV e il Time to First Token. Su Google Kubernetes Engine è inoltre disponibile Cloud Pathways, il runtime DeepMind dietro Gemini, con un’architettura a controller singolo per carichi distribuiti sulle TPU.
Fonti
Google, The Keyword; Google, The Keyword (TPU di ottava generazione); Google Cloud Blog (TorchTPU).
Aiutaci a crescere: lasciaci un like :)