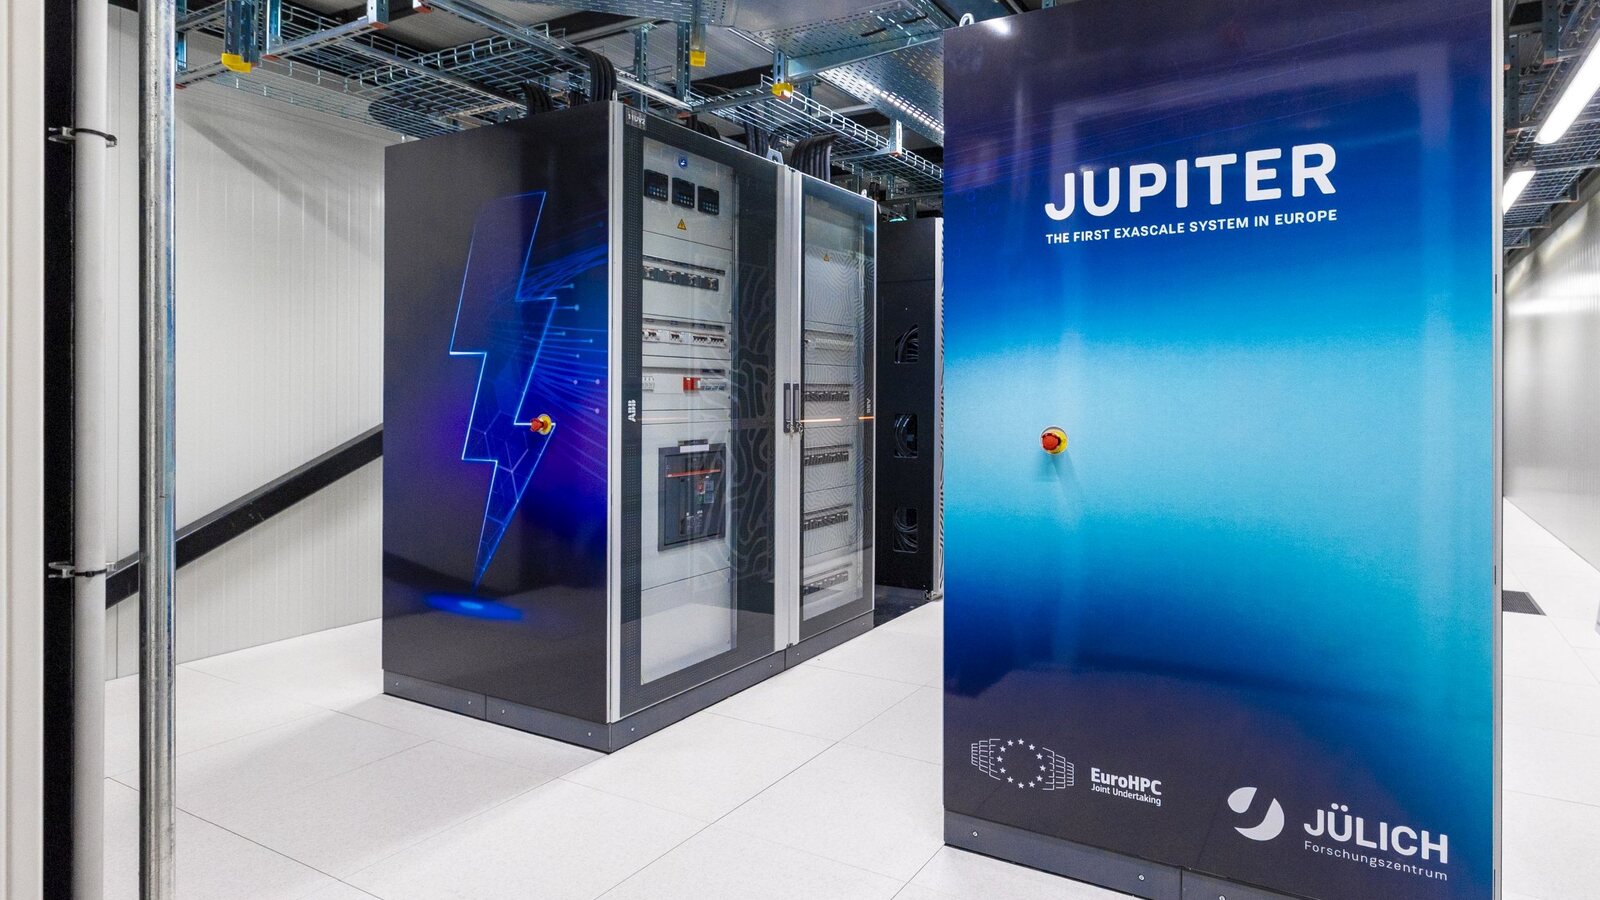


Il consorzio guidato dalla società milanese Domyn ha testato una configurazione da 951,9 miliardi di parametri per EUROPA, il modello di intelligenza artificiale destinato a coprire le 24 lingue ufficiali dell’Unione europea. I risultati, pubblicati il 12 novembre, arrivano da prove sul supercomputer pubblico JUPITER, a Jülich, in Germania. È il primo sistema europeo a raggiungere la scala dell’exaflop, ossia un miliardo di miliardi di operazioni in virgola mobile al secondo. La configurazione sperimentale può ancora cambiare prima dell’addestramento completo. Rapporto tecnico di Domyn · EuroHPC
Il 19 giugno 2026 la Commissione europea ha scelto EUROPA come vincitore della Frontier AI Grand Challenge. Del consorzio fanno parte anche gli istituti tedeschi Fraunhofer IAIS e IIS. Il bando fissava come soglia di riferimento l’equivalente di almeno 400 miliardi di parametri. La proposta vincitrice ne indicava 500 miliardi. Commissione europea · Bando · AI-BOOST
Otto esperti per ogni token
L’architettura Mixture of Experts (MoE) divide parte del modello in sottoreti chiamate «esperti». In ciascuno strato che le usa, il sistema ne seleziona otto su 384 per ogni token, ossia una piccola unità di testo come una parola o un suo frammento. Se si contano anche le parti comuni della rete, i parametri attivi per token sono 32,8 miliardi, circa il 3,4% del totale. Configurazione sperimentale
Da 90 a 1.293 token al secondo per GPU
Le prove hanno impiegato 384 acceleratori NVIDIA GH200 su 96 nodi per replica del modello. Secondo Domyn, la quantità di testo elaborata è passata da 90 a 1.293 token al secondo per GPU, circa 14 volte il valore di partenza. Il dato è la mediana dei passi dal quarto al decimo di ciascuna prova. Tra la configurazione iniziale e quella ottimizzata, le sequenze di addestramento sono passate da 8.192 a 65.536 token. Misure di Domyn
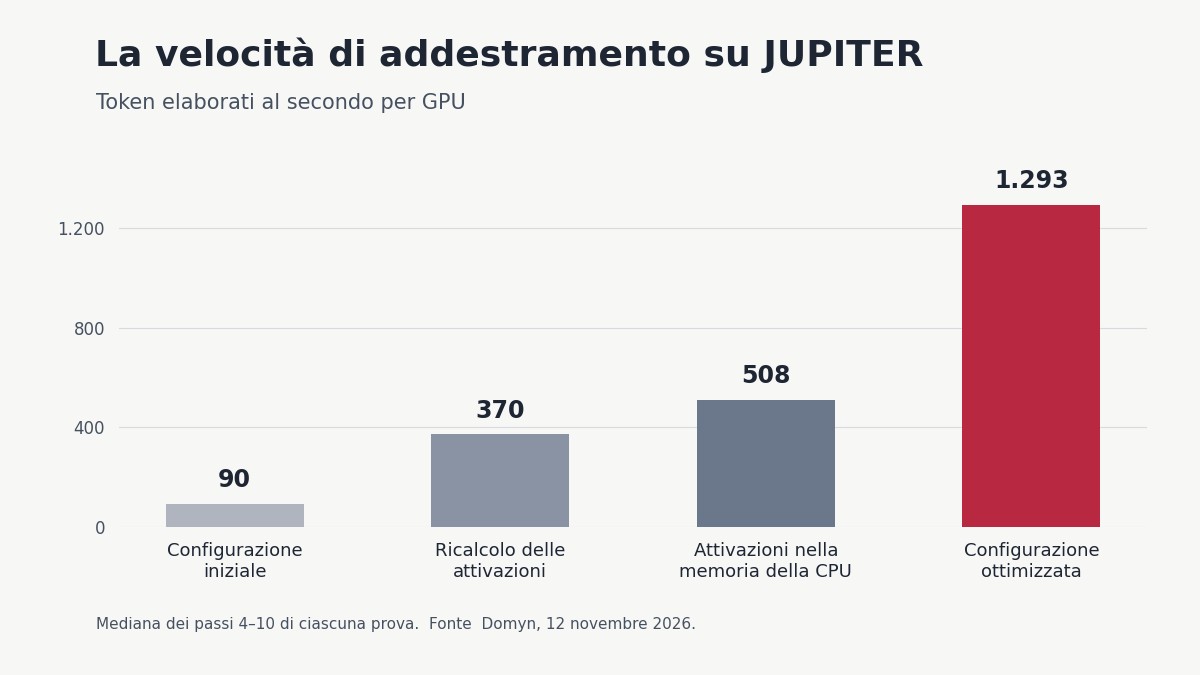
Una parte del lavoro ha riguardato i tempi di attesa delle GPU durante lo scambio di dati fra i nodi. Il team ha inoltre usato la memoria delle CPU per ospitare dati intermedi che occupavano quella delle GPU. Le correzioni al software sono confluite nei progetti PyTorch e TorchTitan. Resoconto del consorzio su PyTorch
Leggi anche Fastweb + Vodafone potenzia il supercomputer NVIDIA per l’AI.
Licenza Apache 2.0 e finestra di rilascio
La proposta vincitrice, secondo il coordinatore del bando AI-BOOST, prevede l’uso esclusivo di dati aperti e il rilascio con licenza Apache 2.0. I pesi, cioè i valori appresi dal modello, sono ancora da pubblicare. Domyn prevede di rilasciarli insieme alle procedure di addestramento. Restano da documentare la composizione del corpus e le prestazioni del modello nelle lingue previste. AI-BOOST · Domyn
Il 14 settembre Domyn ha indicato il secondo semestre del 2027 come finestra di rilascio. La data esatta resta da annunciare. Aggiornamento di Domyn
Foto di apertura di Forschungszentrum Jülich / Sascha Kreklau.
Aiutaci a crescere: lasciaci un like :)