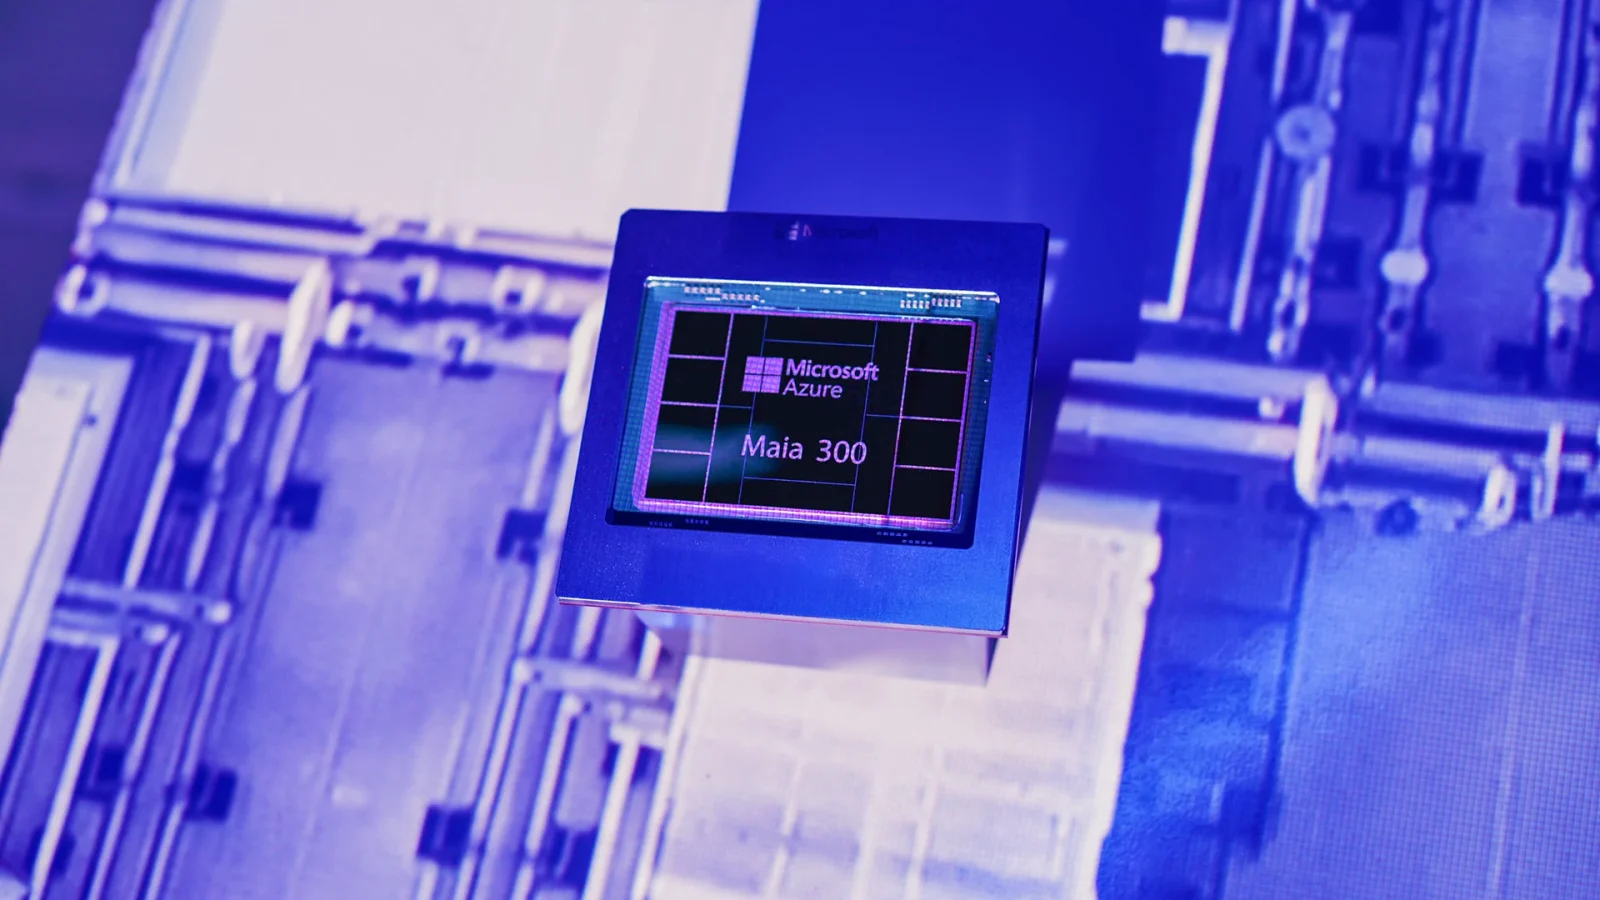

Microsoft ha annunciato Maia 300, la nuova generazione della propria piattaforma per l’inferenza AI, cioè l’esecuzione dei modelli dopo l’addestramento. Le prime installazioni produttive partiranno nel 2027, nell’ambito dell’espansione dell’infrastruttura Azure Maia su scala multi-gigawatt. L’obiettivo dichiarato è rendere Maia il principale sistema di inferenza per i prodotti e i servizi Microsoft.
Le prestazioni dichiarate da Microsoft
Secondo le stime dell’azienda, Maia 300 offrirà il 40% di token in più per megawatt rispetto ai principali sistemi basati su GPU. I token sono le unità di informazione che i modelli elaborano e producono: il confronto riguarda quindi la capacità di erogare servizi AI in rapporto alla potenza disponibile.
Nella configurazione completa con 96 acceleratori, Microsoft dichiara una capacità di elaborazione dei token a livello di rack fino a sette volte superiore a Maia 200. Si tratta di dati del produttore, riferiti al sistema e alle configurazioni indicate, che non equivalgono a una verifica indipendente delle prestazioni. I dettagli sono disponibili nell’annuncio ufficiale Microsoft.
Memoria HBM4 e architettura a chiplet
Maia 300 adotta un’architettura a più chiplet, con componenti distinti per calcolo, controller della memoria e funzioni di ingresso e uscita. I chiplet dedicati al calcolo utilizzano il processo TSMC N2P.
Ogni acceleratore dispone di 288 GB di memoria HBM4, distribuiti su otto stack, con una banda di 18 TB/s. L’architettura punta a ridurre gli spostamenti dei dati e a collocare le informazioni vicino alle unità che le elaborano, un aspetto rilevante per i modelli con contesti estesi e per le attività che richiedono molta memoria. Microsoft descrive questi aspetti nell’approfondimento tecnico su Maia 300.
Un sistema per conversazioni e agenti AI
La piattaforma è progettata per il ragionamento su contesti lunghi, le conversazioni che richiedono risposte rapide e gli agenti AI che svolgono attività articolate in più passaggi.
Microsoft prevede applicazioni per GitHub, nell’assistenza alla scrittura del codice, e per Microsoft Foundry, nell’erogazione dei modelli sul cloud. Tra gli impieghi annunciati figurano anche l’inferenza e la generazione di dati per il team Microsoft AI, oltre alle interazioni di Dragon Copilot destinate ai flussi di lavoro sanitari.
Maia 200 è già in produzione
La nuova generazione si affianca a Maia 200, già impiegato per carichi di lavoro produttivi di Microsoft, tra cui Copilot. L’azienda indica installazioni negli Stati Uniti, in Europa e in Australia e dichiara, per le funzionalità AI integrate in Teams, Copilot e nelle esperienze Cowork, fino a 1,7 volte più token per watt rispetto alle principali infrastrutture GPU.
Aiutaci a crescere: lasciaci un like :)